▶ALForce · Fortran 到 C++ 自动翻译器
| 基准工程 | 规模 | C++ 替换 | 正确性指标 | 性能指标 |
|---|---|---|---|---|
| NASTRAN-95 | 1,850 个文件 / 41.7 万行 F77 | 全部由 C++ 替换 | 基准 132 项 PASS、0 FAIL | 与 Fortran 相当;A/B 对锚 1.010,基准耗时 3.059s |
| MYSTRAN | 1,964 个文件 / 27.3 万行 F90 | 全部由 C++ 替换 | 基准 485 项 PASS、0 FAIL | 已达 1.1x 门限;A/B 对锚 1.007,基准耗时 48.614s |
| Reference-BLAS | 169 个文件 / 4.8 万行 | 全部由 C++ 替换 | 自校验 0 误差:31.6 万项检查全通过 | 与 Fortran 相当,≈ 1.05 |
| Reference-LAPACK | 2,141 个文件 / 91.0 万行 | 全部由 C++ 替换 | 计划断言 215 项 PASS、0 FAIL;自校验 544.4 万项零误差 | 与 Fortran 相当;A/B 对锚 1.009,基准耗时 117.541s |
面向工业级 CAE 求解器的代码迁移难题:直接重写数百万行 Fortran 不现实, 而常规翻译工具产出的 C++ 无法与未翻译的 Fortran 互相调用。 ALForce(Abi Level FORtran Cpp Equivalencer,ABI 级 Fortran→C++ 二进制等价转译器) 在调用约定层面做到双向二进制兼容 —— 翻译后的 C++ 函数可被 尚未翻译的 Fortran 调用方直接调用,未翻译的 Fortran 也可被已翻译的 C++ 调用;两个方向都无需重新编译、无需写胶水层。 因此迁移可以按文件、按目录增量推进,界面上任意处混合编译, 随时可停可回退。
 点击放大
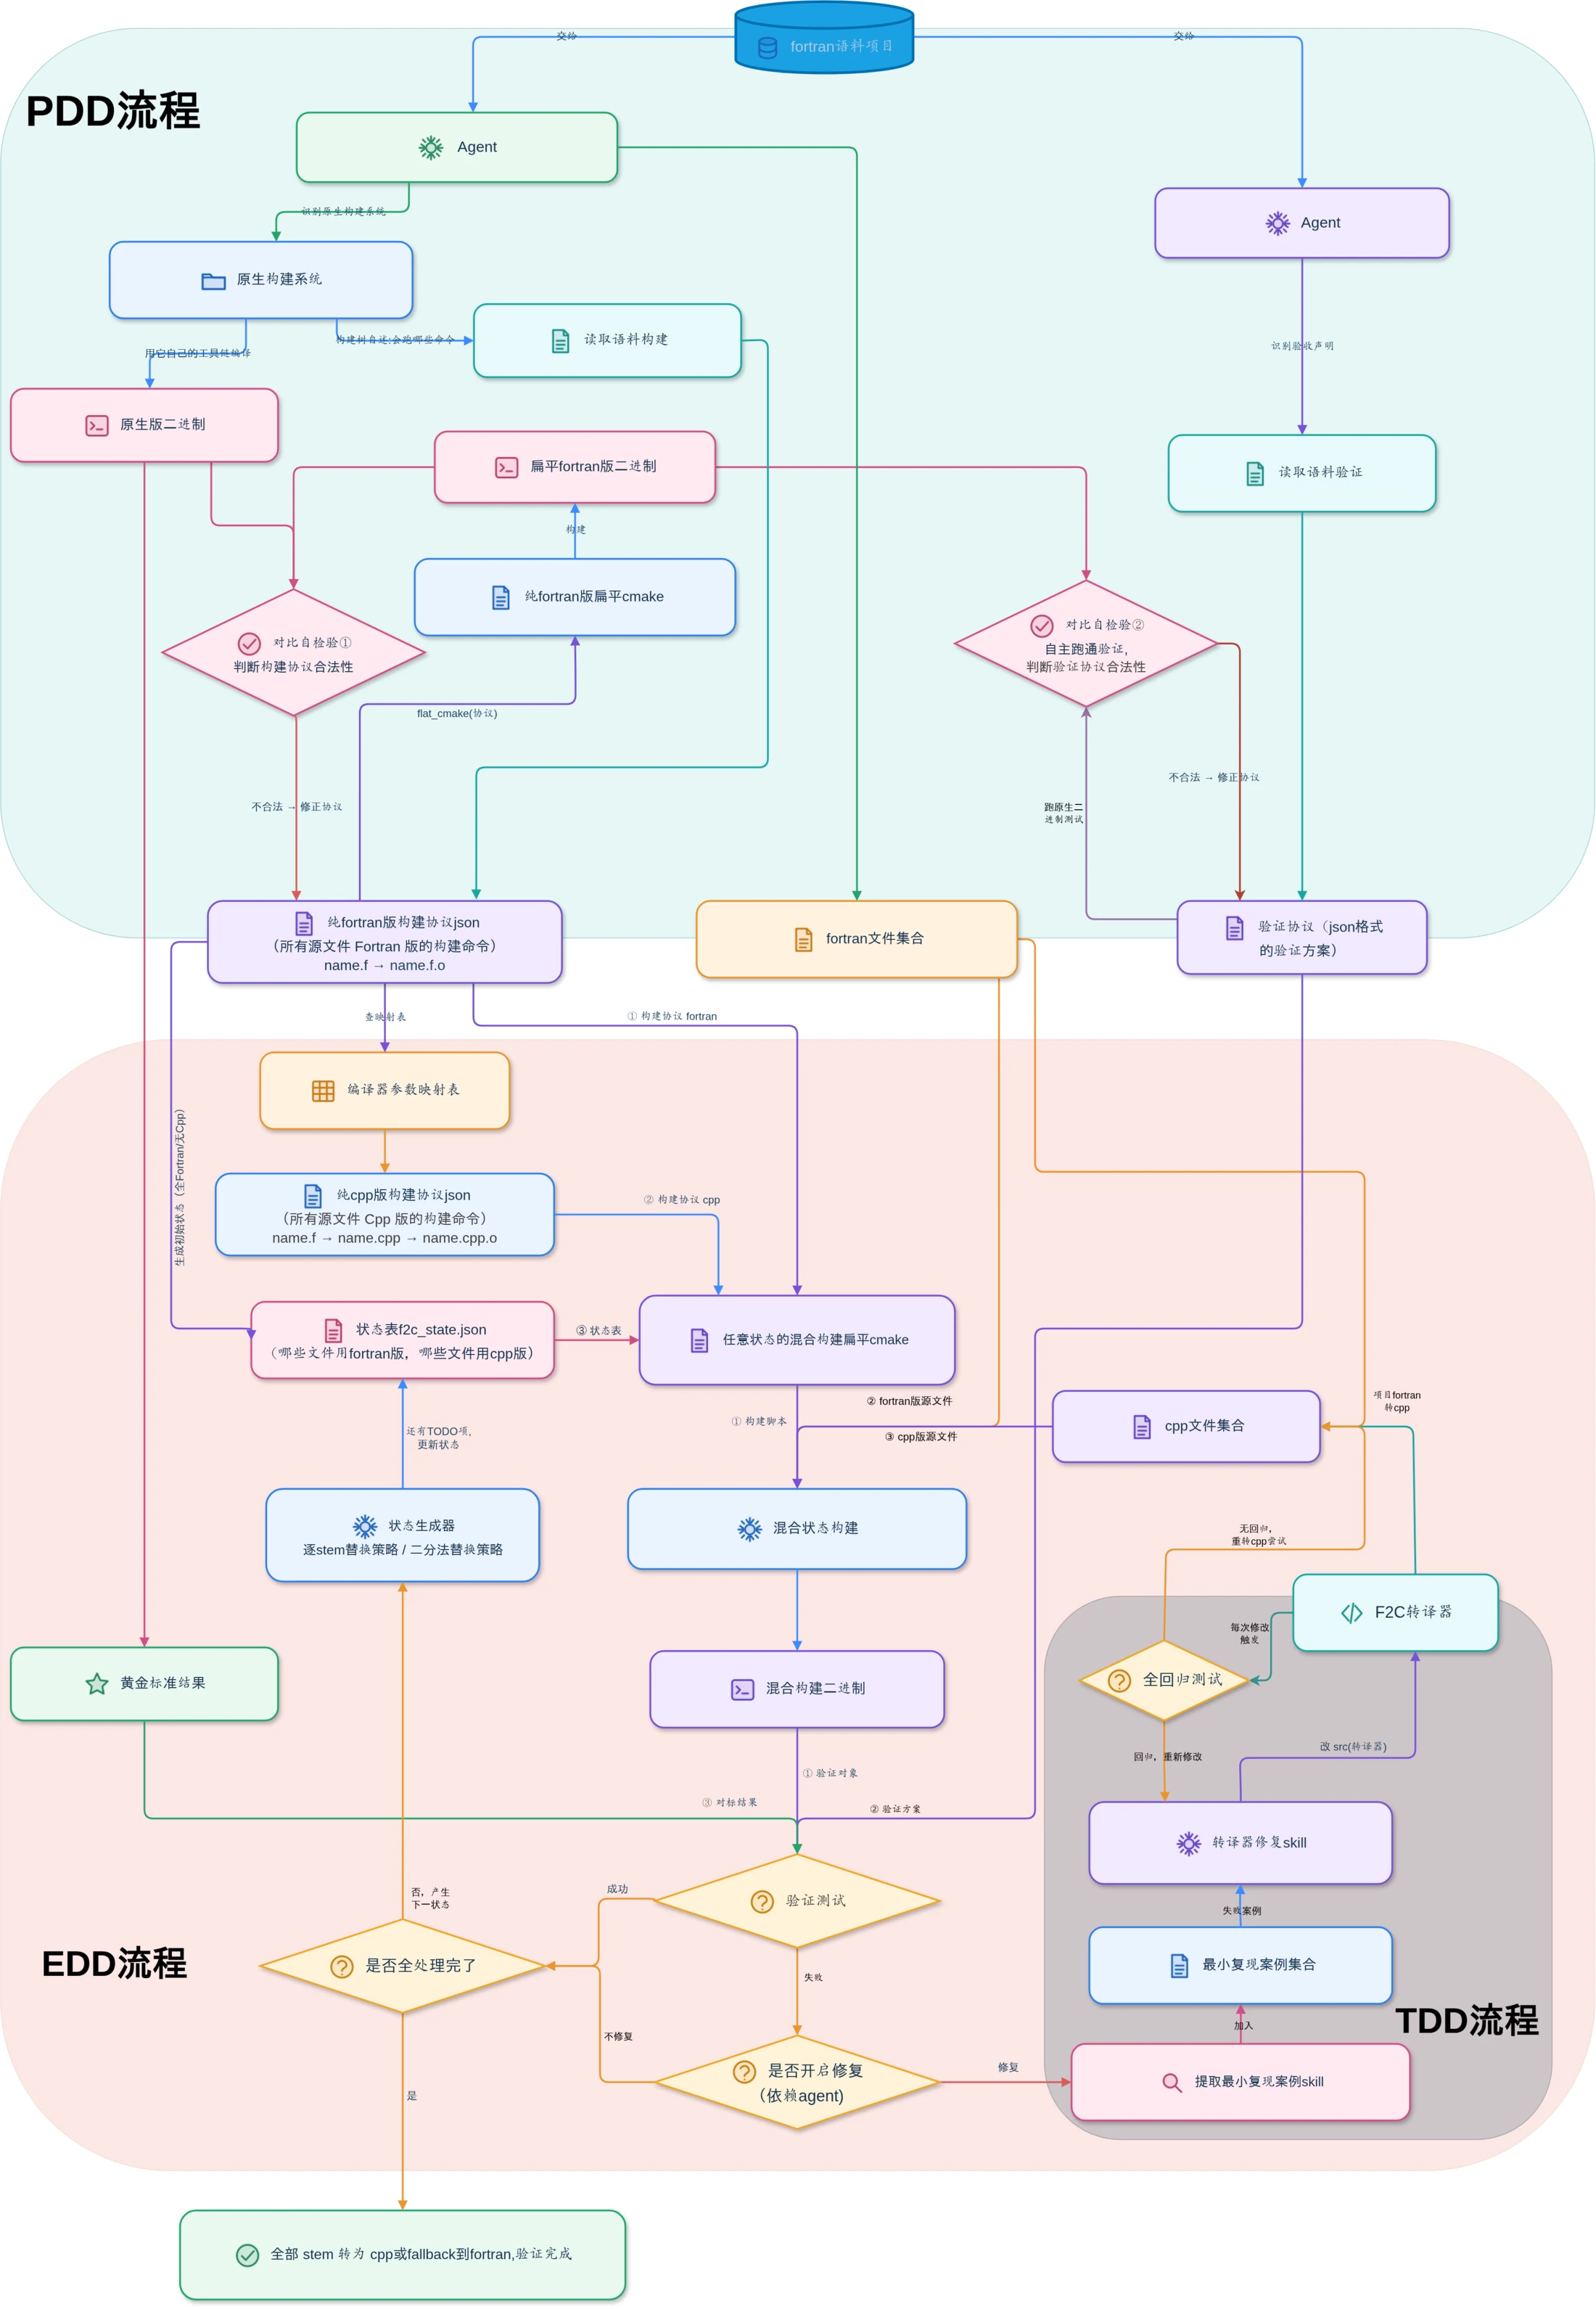
本项目的核心是 F2C 转译器,但它同时是一套 harness 工程 —— 图中每个环节都由自上而下设计的通用 Python 脚本和尽可能少的 agent 编排驱动,每次 agent 调用都有严格的脚本门禁检查,在利用 agent 泛化能力的同时消除不确定性;人只负责提出需求与语料。
主开发方法:基于语料的 TDD转译器自身该支持什么、哪里还有缺陷,全部由语料项目倒推:在真实 Fortran 工程上跑转译与验证,失败用例缩成最小复现回灌给转译器修复,再全量回归,直到全绿。开发进度由语料推进,不由主观排期。
三层:PDD / EDD / TDD整个流程是三层嵌套:PDD(Project-Driven)把真实 Fortran 项目归一成构建协议与验证协议,是语料与需求之源;EDD(Error-Driven)在真实工程上跑转译、把 f2c 引入的错误缩成最小复现案例;TDD(Test-Driven)再由案例集驱动 src/ 的转译器开发,全量回归把关。真实项目 → 协议 → 最小案例 → 转译器,逐层收敛。
面向用户:继续开发转译器的流程在用户有继续开发意愿、并且能够调用 agent 与大语言模型的前提下,用户只需提供语料项目即可, harness 会自验证的自动生成所需的构建协议、验证协议、状态表与混合构建脚本等。agent 在其中承担需要泛化判断的环节,人只需提出目标。
也可退化成纯增量转译流程同一套 harness 也能只当工具用:不依赖 agent,对目标 Fortran 项目做增量转译 —— 手动建好构建协议与验证协议(这一步只需一次),之后便可按制定策略(二分法/逐项)增量替换、增量验证,直至找出目标项目转为cpp的最大成功集合。
理论极限GitHub 上自带验证的开源 Fortran 项目极多,每一个都是现成的语料来源。语料不竭,转译器就能持续逼近完备 —— 理论上可以无限趋近于完美的 Fortran→C++ 转译器。
流程测试测试不止针对转译器,流程本身也有测试,scripts_v2/tests下构建了一套dummy测试,尽最大可能保证不会有流程bug带来的假阳性、假阴性。
转译器最终要能替换人写的代码,所以这三个目标必须同时成立 —— 每个目标背后都有一道具体的测试闸门,而不是一句设计口号。最小复现案例也按这三个目标分了三类:正确性验证、性能验证、可读性验证。
正确性 · 功能与 Fortran 原版完全一致
转出来的 C++ 跑出来的结果,必须和 Fortran 原版在同一算例下完全一致。
怎么保证正确性验证这一类,由 1,743 个测试算例逐项比对输出(1,714 PASS、0 FAIL、29 SKIP),其中自带校验的最小复现案例是主力 —— e2e_single类测试(单文件,1,255 个)与 e2e_multi类测试(多文件,266 个)覆盖常见语法特性;四个基准工程再各自完整跑一遍基准 —— 132 + 485 + 215 个算例 PASS、0 FAIL,LAPACK 侧另有 544 万项、BLAS 侧 31.6 万项数值检查零误差。
性能 · 不被转译拖慢
语言的性能由编译器优化与语言各自的运行时共同决定,不存在谁天然更快的定论。F2C 用 C++ 语法模拟 Fortran 语义,很多情况下会不可避免地多出一些函数调用等开销;但 C++ 的底层开放性让我们能在惰性求值、小对象优化等方面做更精细的控制,把这些损失补回来 —— 微基准上可以跑到比 Fortran 更快。
怎么保证性能验证这一类,由 tests/perf/ 的数十个微基准逐项测 C++ 与 Fortran 的耗时比;工程级则由基准门槛把关,四个基准项目都进了 1.1x 门限内,并做 A/B 对锚:同机交替跑当前构建与锚定二进制(锚 = all_pass 归档 1ea3fe10 的二进制,sha 与 META 核对一致),三次比值 1.010 / 1.007 / 1.009,锚区间与 current 区间不重叠,真差异约 0.8%,在门限之内。
可读性 · 转出来的 C++ 要像 Fortran
产物尽量贴近原 Fortran 的结构,把难读的底层处理封到 C++ 侧的 runtime 里,不摊到生成的代码里。
怎么保证C++ 侧的 runtime 用 C++ 实现了一套模仿 Fortran 语义的设施:数组写成 a(i,j) 的 1 起始、列主序 f2c::arr,切片与区段这类 Fortran 惯用写法(p(2:4)、a(i, :)) 直接落在 runtime 的接口上,产物里看不到裸指针加长度;性能上的取舍则封在这层接口底下。 可读性验证这一类,由 codegen_check 用例直接对转出来的 C++ 本身断言 —— 检查产物里该出现与不该出现的写法(例如块数据必须走 runtime 初始化、PARAMETER 必须是编译期常量而非可变 static),盯住可读性的下限。
精力有限,本项目目前没有在 Windows 上做任何测试;开发环境为 Ubuntu 24.04 LTS。不论哪个版本的 Fortran 标准都非常古老,其中还有大量以现代编程语言的标准看相当匪夷所思的语法。 尽管本项目尽量采用高强度的语料项目做迭代开发,仍然不能 100% 保证覆盖所有 corner case。退而求其次的办法是可以退化成混编模式 —— 把 Fortran 代码的范围降到最小,剩下的部分照常转成 C++。
文件号无法跨语言传递
Fortran 的 open / write / read 都按文件号操作,而文件号由 Fortran 编译器与运行时全局管理 —— 同一个文件号可以跨程序单元、跨文件传递。
后果一旦 open 在一端、write 在另一端(一侧已转成 C++,另一侧还是 Fortran),文件号就 没法跨语言传输,两边各自维护的号表对不上。
module 的 .mod 无法随转译保留
module 编译会产出 .mod。转成 C++ 后不可能再有这个功能 —— 接口变成了 C 接口(符号名的 mangle 能保证一致),但没有 .mod。
做法对项目做分层:必须先转消费者,消费者都转成了 C++,生产者才进入队列,这在一定程度上解决了问题。 但如果用户的转换目标是一个 Fortran 库、库里包含 modules,转出来就是没有 mod;当该 module 的外部消费者也是个 Fortran 时,那就链接不上了。
编译速度非常慢
转出来的 C++ 编译很慢,工程规模一大,构建时间就成为明显的负担。
说明没有模块(import 语句)、泛型编程编译慢等,是 C++(非最新版)臭名昭著的特性 —— 头文件在每个翻译单元里重复解析、模板在编译期展开,开销随工程规模放大;这不是转译环节引入的。它在增量编译下 会有所掩盖 —— 只改动少量文件时,重编的部分有限;但全量编译下总时间可能比原 Fortran 版增加几倍。
缓解项目自身可以改造构建系统(如预编译),尽可能利用增量编译;但这不在本项目范围内 —— 构建速度本身也不是本项目的关注重点。